


Stable Diffusion là gì? Cách chạy và những gì cần biết về bản quyền

Mục lục
Stable Diffusion là mô hình AI tạo ảnh từ chữ, trọng số tải về được. Cách hoạt động bằng lời thường, chạy trên đám mây hay trên máy, Community License, bản quyền ảnh AI theo luật Việt Nam và dùng có trách nhiệm.
Trả lời nhanh: Stable Diffusion là một dòng mô hình AI tạo ảnh từ mô tả bằng chữ, có trọng số (weights) công bố để tải về, nên bạn chạy được trên máy của mình hoặc dùng qua dịch vụ đám mây. Bản đầu do nhóm CompVis làm cùng Stability AI và Runway, dựa trên nghiên cứu "latent diffusion"; các bản mới như Stable Diffusion 3.5 do Stability AI phát hành. Dùng thương mại được hay không tuỳ giấy phép của từng mô hình, còn luật bản quyền với ảnh AI vẫn đang thay đổi.
| Câu hỏi | Trả lời ngắn (theo nguồn chính thức) | Xem ở mục |
|---|---|---|
| Stable Diffusion là gì? | Mô hình tạo ảnh từ chữ, kiểu "latent diffusion", trọng số trên Hugging Face | Là gì |
| Hoạt động thế nào? | Bắt đầu từ nhiễu, khử nhiễu từng bước trong không gian nén, theo câu mô tả | Hoạt động |
| Chạy ở đâu? | Trên máy (cần card đồ hoạ mạnh) hoặc qua API, đối tác đám mây, ứng dụng web | Cách chạy |
| Dùng thương mại được không? | Bản 3.5: được theo Community License khi doanh thu năm dưới 1 triệu USD, phải đăng ký | Giấy phép |
| Ảnh tạo ra có bản quyền không? | Chưa có câu trả lời chung; giấy phép ghi "to the extent permitted by applicable law" | Bản quyền |
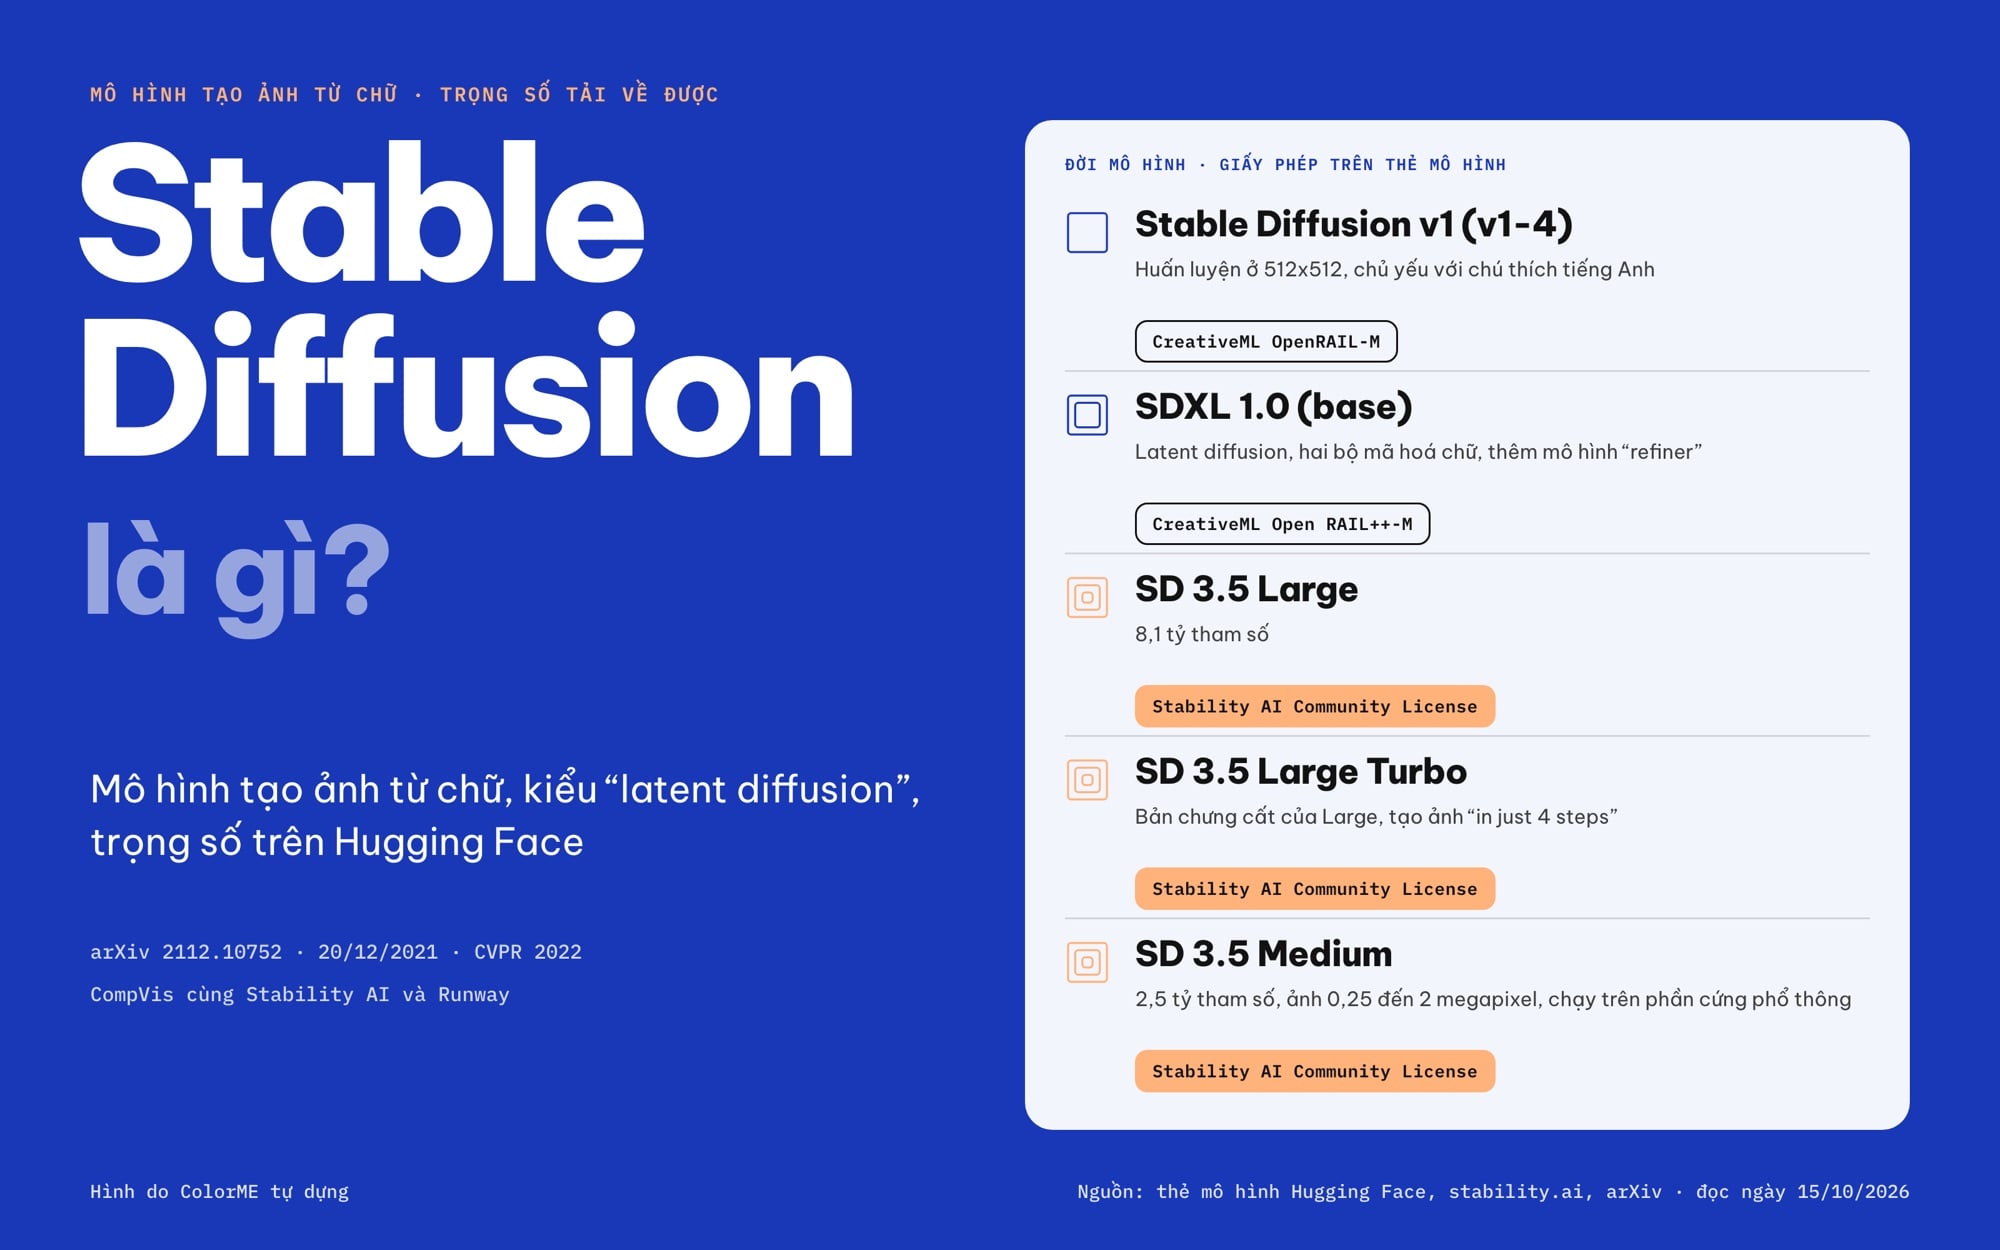
Các đời Stable Diffusion và giấy phép ghi trên thẻ mô hình. Hình do ColorME tự dựng.
Thông tin lấy từ trang của Stability AI, thẻ mô hình (model card) trên Hugging Face, bài báo gốc trên arXiv và GitHub của các phần mềm chạy Stable Diffusion, mình đọc ngày 15/10/2026. ColorME không chạy mô hình cho bài này: không có ảnh do Stable Diffusion tạo, hình minh hoạ là bảng ColorME tự thiết kế.
Stable Diffusion là gì?
Stable Diffusion là mô hình "text-to-image": bạn gõ câu mô tả (prompt), mô hình tạo ảnh. Thẻ mô hình bản v1-4 viết: "Stable Diffusion is a latent text-to-image diffusion model capable of generating photo-realistic images given any text input" (Hugging Face, CompVis).
GitHub của nhóm CompVis ghi Stable Diffusion "was made possible thanks to a collaboration with Stability AI and Runway"; nhờ "a generous compute donation from Stability AI and support from LAION", nhóm huấn luyện mô hình trên ảnh 512x512 từ một phần bộ dữ liệu LAION-5B (GitHub CompVis). Nền tảng kỹ thuật là bài báo "High-Resolution Image Synthesis with Latent Diffusion Models" của Robin Rombach và cộng sự, đăng arXiv ngày 20/12/2021, trình bày ở CVPR 2022 (arXiv 2112.10752).
Khác với nhiều công cụ tạo ảnh chỉ dùng qua web, trọng số Stable Diffusion được đưa lên Hugging Face để tải. Vì vậy có cả hệ sinh thái phần mềm (ComfyUI, Stable Diffusion web UI...) và bản tinh chỉnh của cộng đồng. Mỗi đời mô hình có giấy phép riêng:
| Đời mô hình | Nguồn ghi | Giấy phép trên thẻ mô hình |
|---|---|---|
| Stable Diffusion v1 (v1-4) | Huấn luyện ở 512x512, chủ yếu với chú thích tiếng Anh | CreativeML OpenRAIL-M |
| SDXL 1.0 (base) | Latent diffusion, hai bộ mã hoá chữ, thêm mô hình "refiner" | CreativeML Open RAIL++-M |
| SD 3.5 Large | 8,1 tỷ tham số, "ideal for professional use cases at 1 megapixel resolution" | Stability AI Community License |
| SD 3.5 Large Turbo | Bản chưng cất của Large, tạo ảnh "in just 4 steps" | Stability AI Community License |
| SD 3.5 Medium | 2,5 tỷ tham số, ảnh 0,25 đến 2 megapixel, chạy trên phần cứng phổ thông | Stability AI Community License |
Nguồn: thẻ mô hình SDXL base 1.0, SD 3.5 Large, SD 3.5 Medium và bài giới thiệu Stable Diffusion 3.5 của Stability AI ngày 22/10/2024, cập nhật 29/10 khi ra bản Medium (stability.ai).
Stable Diffusion hoạt động thế nào? Giải thích bằng lời thường
Mô hình "diffusion" học cách biến một ảnh toàn nhiễu (như màn hình TV mất sóng) thành ảnh rõ nét, bằng cách khử nhiễu nhiều lần, mỗi lần một ít. Bài báo gốc gọi đó là "a sequential application of denoising autoencoders". Khử nhiễu trực tiếp trên từng điểm ảnh rất tốn máy: bài báo viết việc huấn luyện "often consumes hundreds of GPU days". Nhóm tác giả chuyển việc khử nhiễu vào "latent space", một bản nén của ảnh do bộ tự mã hoá (autoencoder) tạo ra, và thêm lớp "cross-attention" để câu chữ điều khiển được ảnh.
Thẻ mô hình v1-4 tả các bước khi huấn luyện:
- Nén ảnh: ảnh H x W x 3 thành latent H/8 x W/8 x 4 ("a relative downsampling factor of 8").
- Đọc câu mô tả: prompt đi qua bộ mã hoá chữ CLIP ViT-L/14, rồi vào mạng UNet qua cross-attention.
- Học khử nhiễu: latent được thêm nhiễu, mô hình học đoán lại phần nhiễu đó.
Khi tạo ảnh thì đi ngược lại: từ latent toàn nhiễu, khử nhiễu từng bước theo hướng prompt, cuối cùng bộ giải mã biến latent thành ảnh. Thẻ mô hình cũng ghi "The autoencoding part of the model is lossy": phần nén làm mất một ít chi tiết.
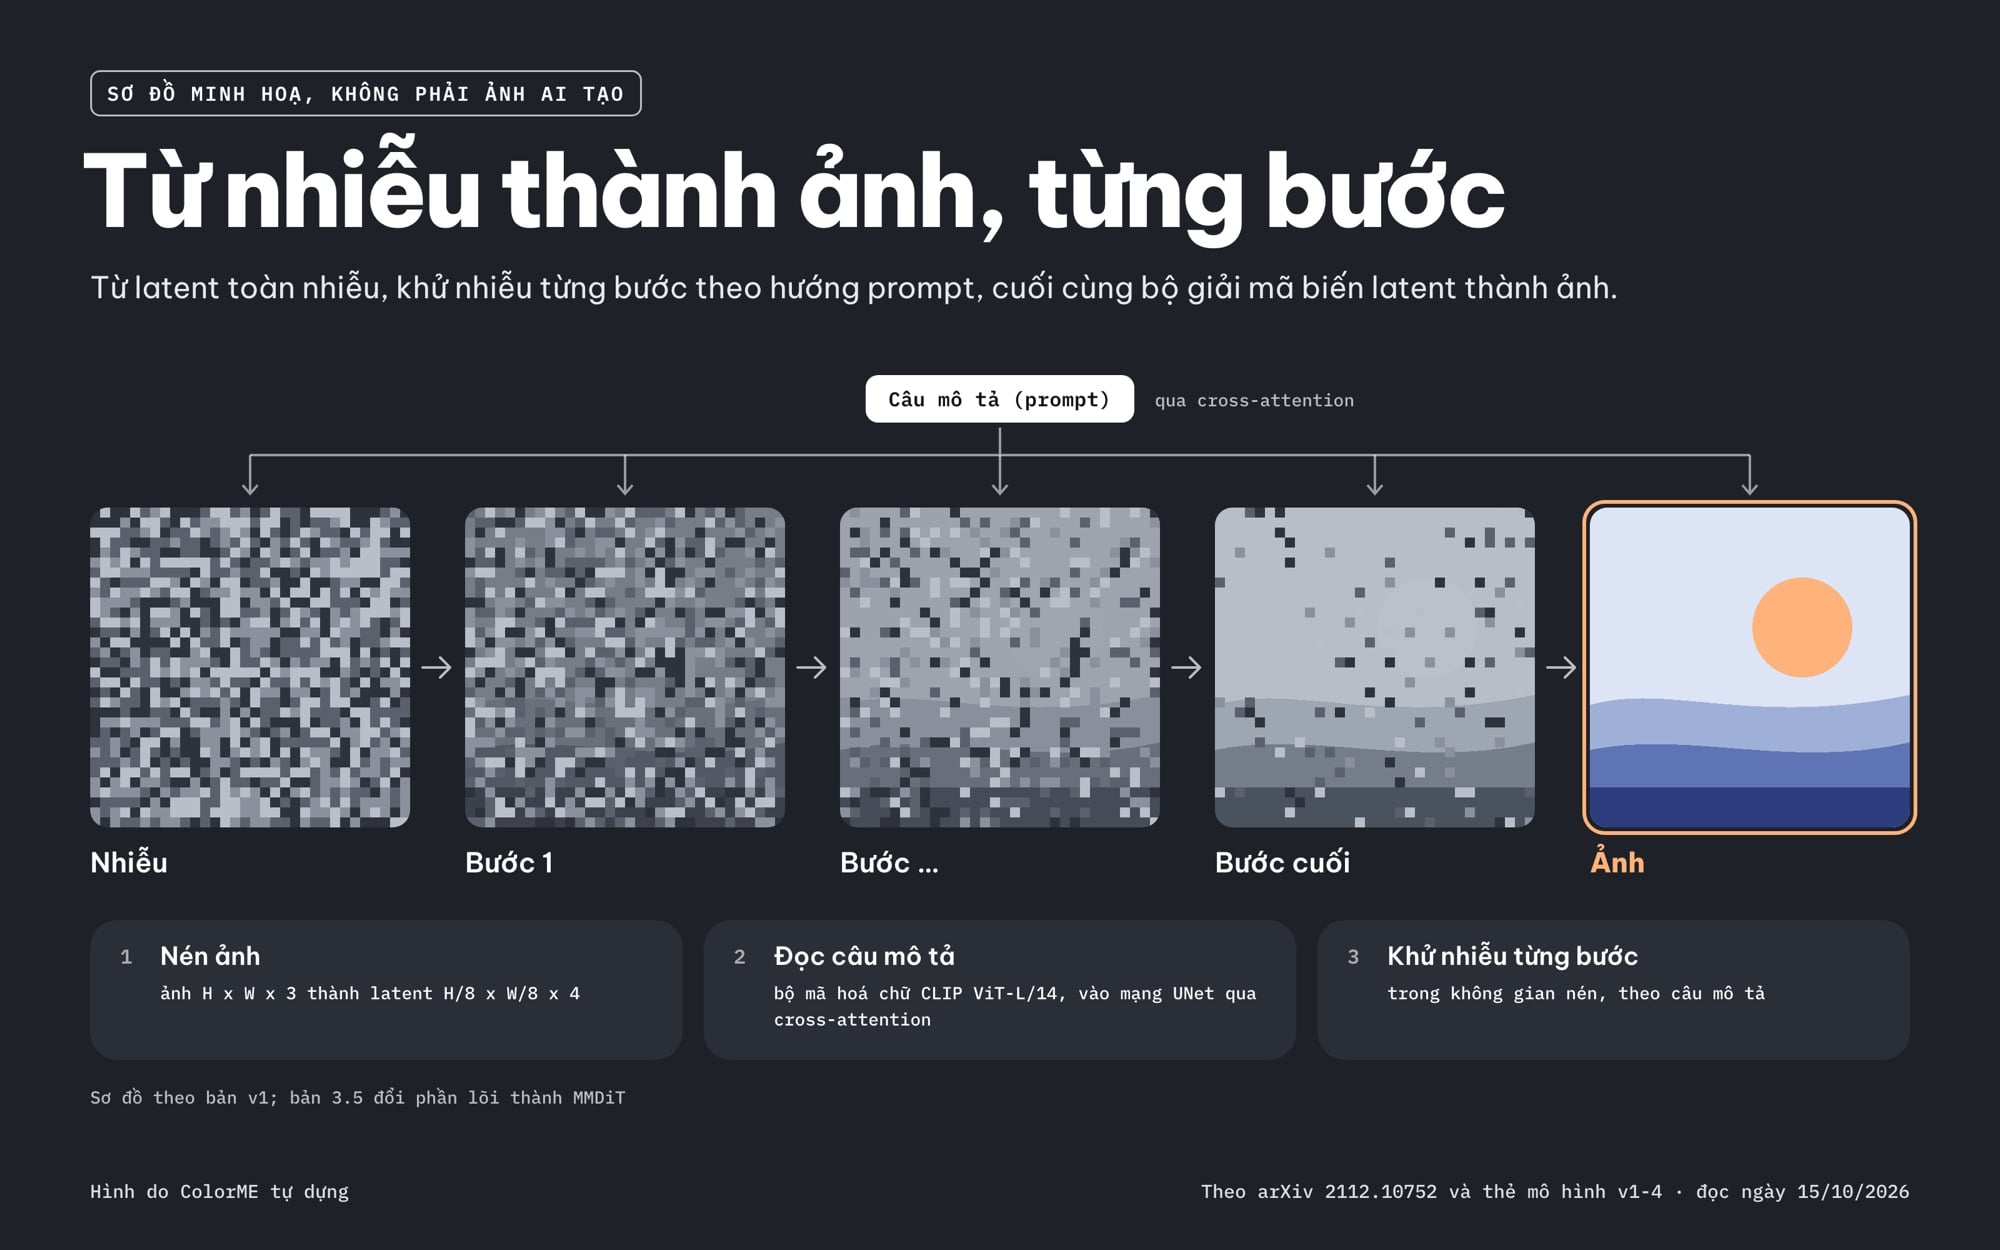
Sơ đồ minh hoạ khử nhiễu từng bước, không phải ảnh AI tạo. Hình do ColorME tự dựng.
Bản 3.5 đổi phần lõi thành "Multimodal Diffusion Transformer (MMDiT)" với ba bộ mã hoá chữ (hai CLIP, một T5), theo thẻ SD 3.5 Large.
Stable Diffusion làm được gì, chưa làm tốt điều gì?
GitHub của Stable Diffusion web UI (AUTOMATIC1111) ghi "Original txt2img and img2img modes" và "Inpainting" (GitHub AUTOMATIC1111); ComfyUI liệt kê công cụ có sẵn cho "inpainting, outpainting, reference conditioning, masks and compositing, model merging, upscaling" (GitHub ComfyUI).
| Kiểu việc | Nghĩa là | Ví dụ trong thiết kế (thường gặp) |
|---|---|---|
| txt2img | Tạo ảnh mới từ câu mô tả | Phác nhiều hướng moodboard |
| img2img | Lấy ảnh có sẵn làm điểm xuất phát | Biến bản phác chì thành phương án màu |
| Inpainting | Vẽ lại một vùng tô mặt nạ | Đổi vật trên bàn trong ảnh sản phẩm của bạn |
| Outpainting | Mở rộng ảnh ra ngoài khung | Nới nền ảnh dọc thành ảnh ngang |
| Fine-tune, LoRA | Tinh chỉnh mô hình bằng dữ liệu riêng | Giữ phong cách minh hoạ team tự vẽ |
Điểm chưa tốt thì chính thẻ mô hình nói ra. Thẻ v1-4 ghi mô hình "cannot render legible text", "Faces and people in general may not be generated properly", làm kém các yêu cầu bố cục như "A red cube on top of a blue sphere", và "will not work as well in other languages" vì huấn luyện chủ yếu bằng chú thích tiếng Anh. Trang Core Models ghi ngôn ngữ các bản SD 3.5 là "English" (stability.ai), nên prompt tiếng Anh thường ổn định hơn prompt tiếng Việt.
Bản 3.5 được giới thiệu là cải thiện "typography" và hiểu prompt phức tạp, nhưng Stability AI cũng viết prompt thiếu cụ thể "might lead to increased uncertainty in the output". Mọi thẻ mô hình mình đọc đều ghi mô hình "was not trained to be factual or true representations of people or events": đừng dùng nó để làm ảnh "thật" về người hay sự kiện.
Cách chạy Stable Diffusion: trên đám mây hay trên máy của bạn?
Trang Stable Diffusion 3.5 của Stability AI nêu bốn cách dùng (stability.ai/stable-image):
- Self-Hosted License: "Deploy our models in your environment", tải mô hình về chạy trên máy hoặc máy chủ của bạn.
- Stability AI API: gọi mô hình qua API trong ứng dụng bạn tự xây.
- Cloud Partners: dùng trong hệ sinh thái đối tác đám mây, "with no need for additional infrastructure".
- Stable Assistant: "a web-based creative platform" để tạo và sửa ảnh.
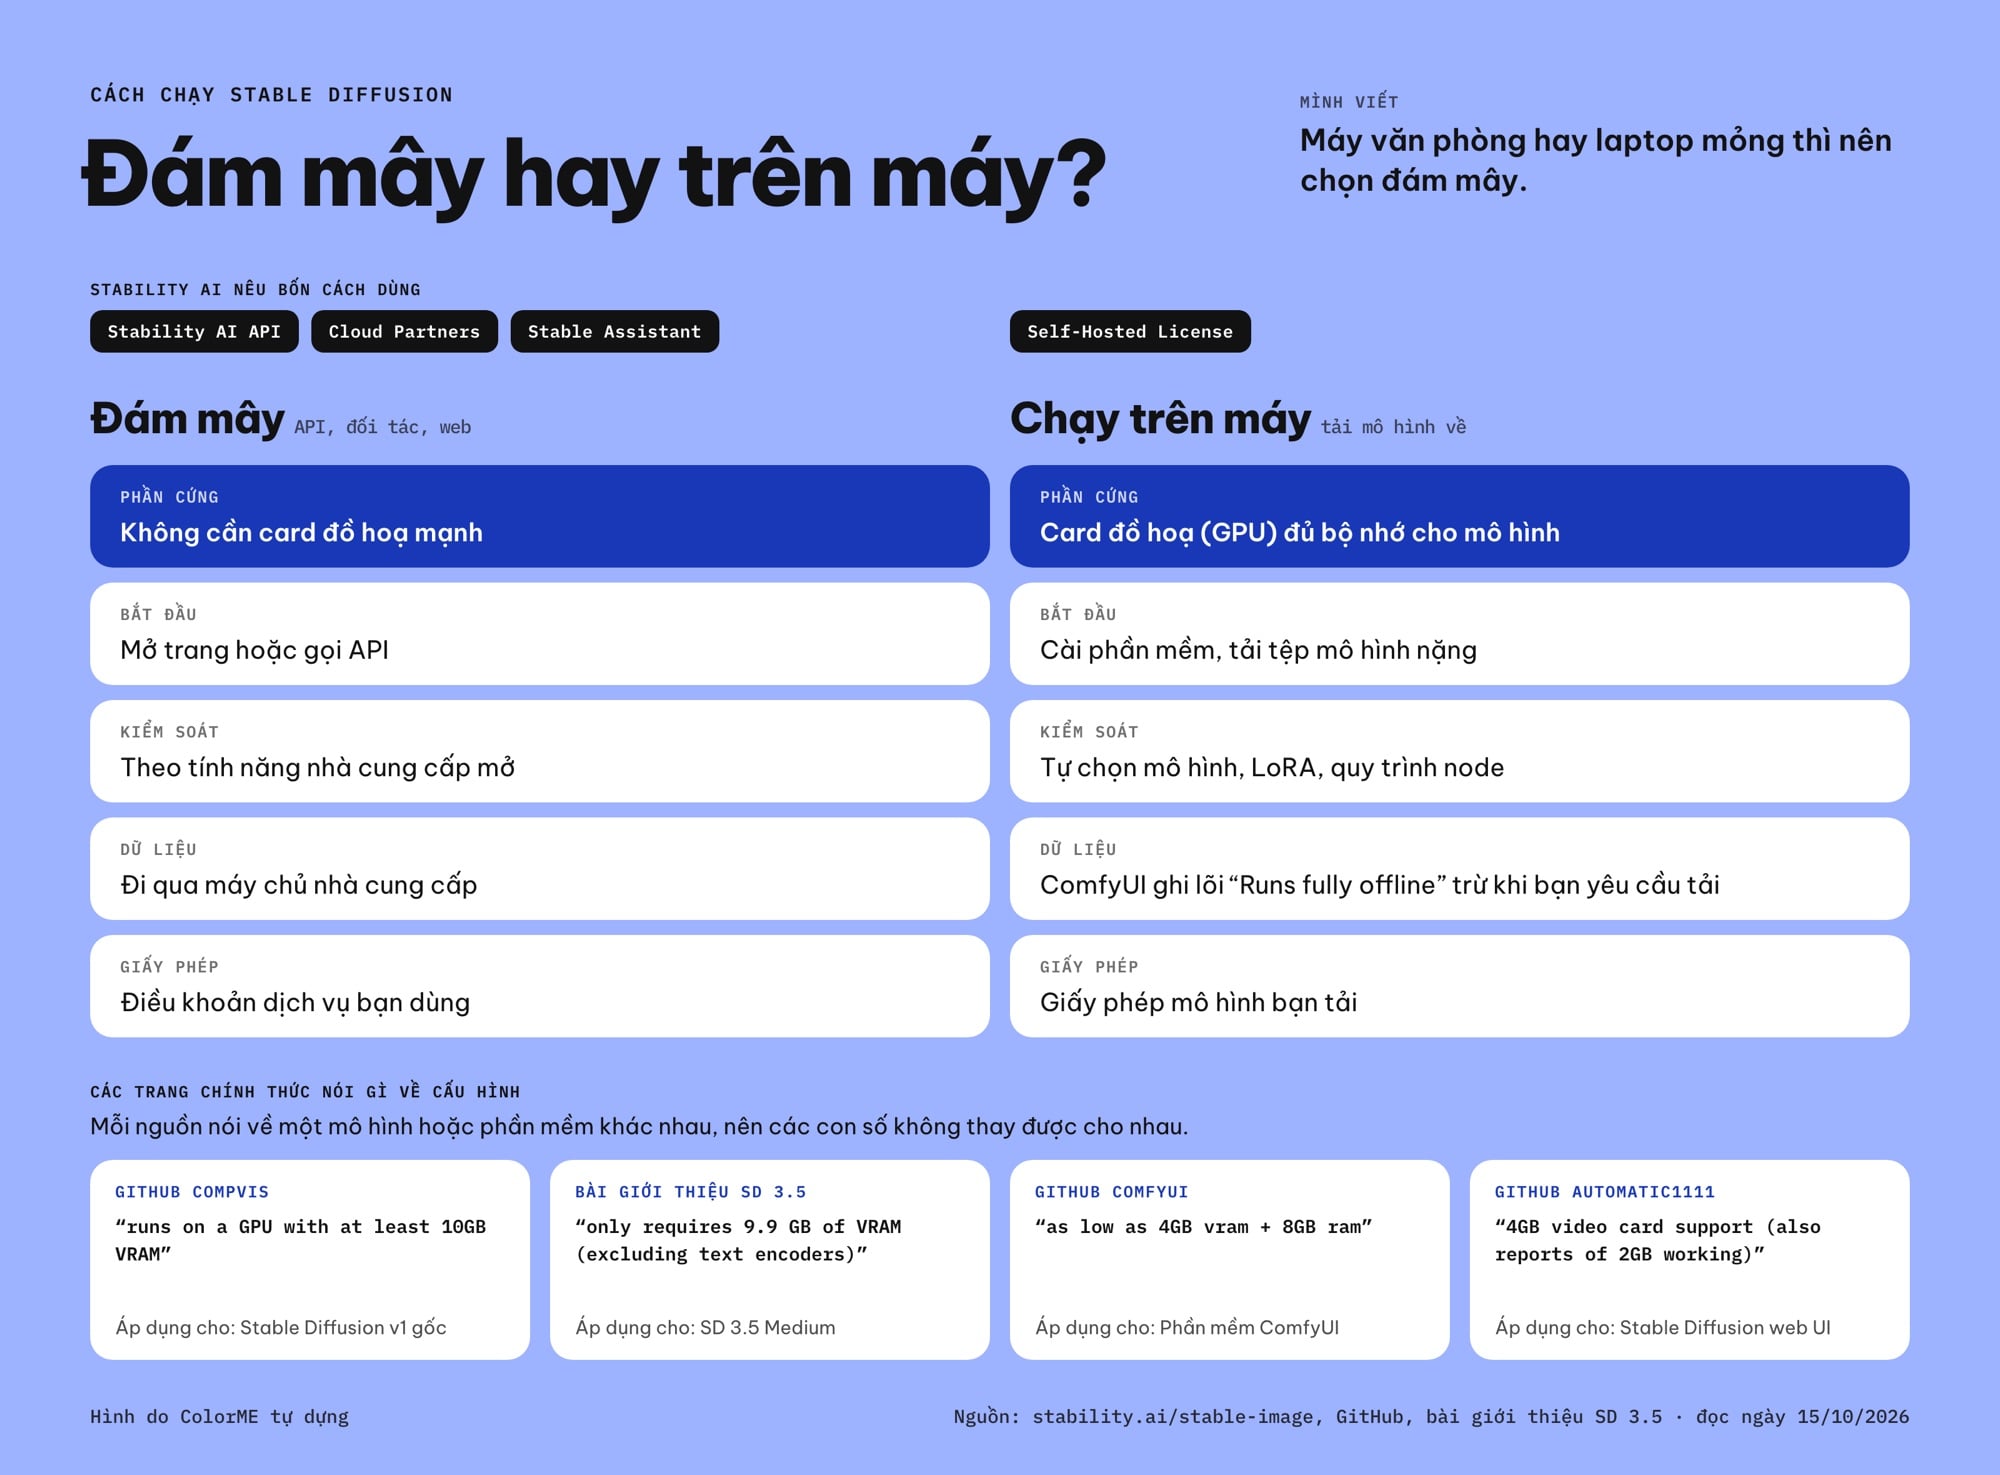
Đám mây hay trên máy, kèm bốn câu chính thức về cấu hình. Hình do ColorME tự dựng.
| Bạn cần | Đám mây (API, đối tác, web) | Chạy trên máy |
|---|---|---|
| Phần cứng | Không cần card đồ hoạ mạnh | Card đồ hoạ (GPU) đủ bộ nhớ cho mô hình |
| Bắt đầu | Mở trang hoặc gọi API | Cài phần mềm, tải tệp mô hình nặng |
| Kiểm soát | Theo tính năng nhà cung cấp mở | Tự chọn mô hình, LoRA, quy trình node |
| Dữ liệu | Đi qua máy chủ nhà cung cấp | ComfyUI ghi lõi "Runs fully offline" trừ khi bạn yêu cầu tải |
| Giấy phép | Điều khoản dịch vụ bạn dùng | Giấy phép mô hình bạn tải |
Chạy trên máy: các trang chính thức nói gì về cấu hình
Mỗi nguồn nói về một mô hình hoặc phần mềm khác nhau, nên các con số không thay được cho nhau. Mình chép đúng câu họ viết:
| Nguồn | Họ viết | Áp dụng cho |
|---|---|---|
| GitHub CompVis | "runs on a GPU with at least 10GB VRAM" | Stable Diffusion v1 gốc |
| Bài giới thiệu SD 3.5 | "only requires 9.9 GB of VRAM (excluding text encoders)" | SD 3.5 Medium |
| GitHub ComfyUI | "as low as 4GB vram + 8GB ram", nhờ "asynchronous weight streaming" | Phần mềm ComfyUI |
| GitHub AUTOMATIC1111 | "4GB video card support (also reports of 2GB working)" | Stable Diffusion web UI |
ComfyUI có ứng dụng desktop "Available on Windows & macOS", gọi là "The easiest way to get started"; bản cài thủ công "Supports all operating systems and GPU types (NVIDIA, AMD, Intel, Apple Silicon, Ascend)"; và có bản đám mây chính thức Comfy Cloud cho người không có phần cứng phù hợp. Thẻ SD 3.5 Large viết: "For local or self-hosted use, we recommend ComfyUI". Stable Diffusion web UI ghi card NVIDIA "(recommended)", có hướng dẫn cho AMD, Intel, Apple Silicon; bản phát hành mới nhất trên GitHub là v1.10.1 ngày 09/02/2025.
Quy trình chung theo các trang trên: cài phần mềm giao diện, tải tệp mô hình từ Hugging Face (trang tải các bản 3.5 yêu cầu bấm "Agree" và điền thông tin), đặt tệp checkpoint vào thư mục mô hình (ComfyUI ghi "ComfyUI\models\checkpoints"), rồi viết prompt. Đây là mô tả để bạn hình dung, không phải hướng dẫn từng bước: ColorME không chạy Stable Diffusion trên máy cho bài này. Chạy mô hình ảnh trên máy rất nặng: card đồ hoạ chạy hết công suất, máy nóng, tệp mô hình chiếm nhiều dung lượng. Máy văn phòng hay laptop mỏng thì nên chọn đám mây.
Giấy phép Stable Diffusion: có được dùng thương mại không?
"Tải về được" không có nghĩa là dùng thế nào cũng được. Các bản 3.5 dùng Stability AI Community License Agreement, cập nhật lần cuối 05/07/2024 (stability.ai). Điểm chính, theo đúng văn bản:
| Điều khoản | Văn bản giấy phép viết |
|---|---|
| Mục đích | "research, non-commercial, and limited commercial uses of the Models free of charge" |
| Ngưỡng doanh thu | Cho người hoặc tổ chức có "annual revenue of less than US $1,000,000 (or local currency equivalent)" |
| Dùng thương mại | "You must register with Stability AI" |
| Vượt ngưỡng | Giấy phép chấm dứt từ ngày đó; phải xin giấy phép từ Stability AI |
| Khi phân phối | Kèm bản giấy phép, tệp "Notice", hiển thị "Powered by Stability AI" |
| Ảnh tạo ra | "You own any outputs ... to the extent permitted by applicable law" (giữa bạn và Stability AI) |
| Hạn chế | Theo luật và Acceptable Use Policy; không dùng để "create or improve any foundational generative AI model" |
| Chấm dứt | Stability AI có thể chấm dứt nếu bạn vi phạm |
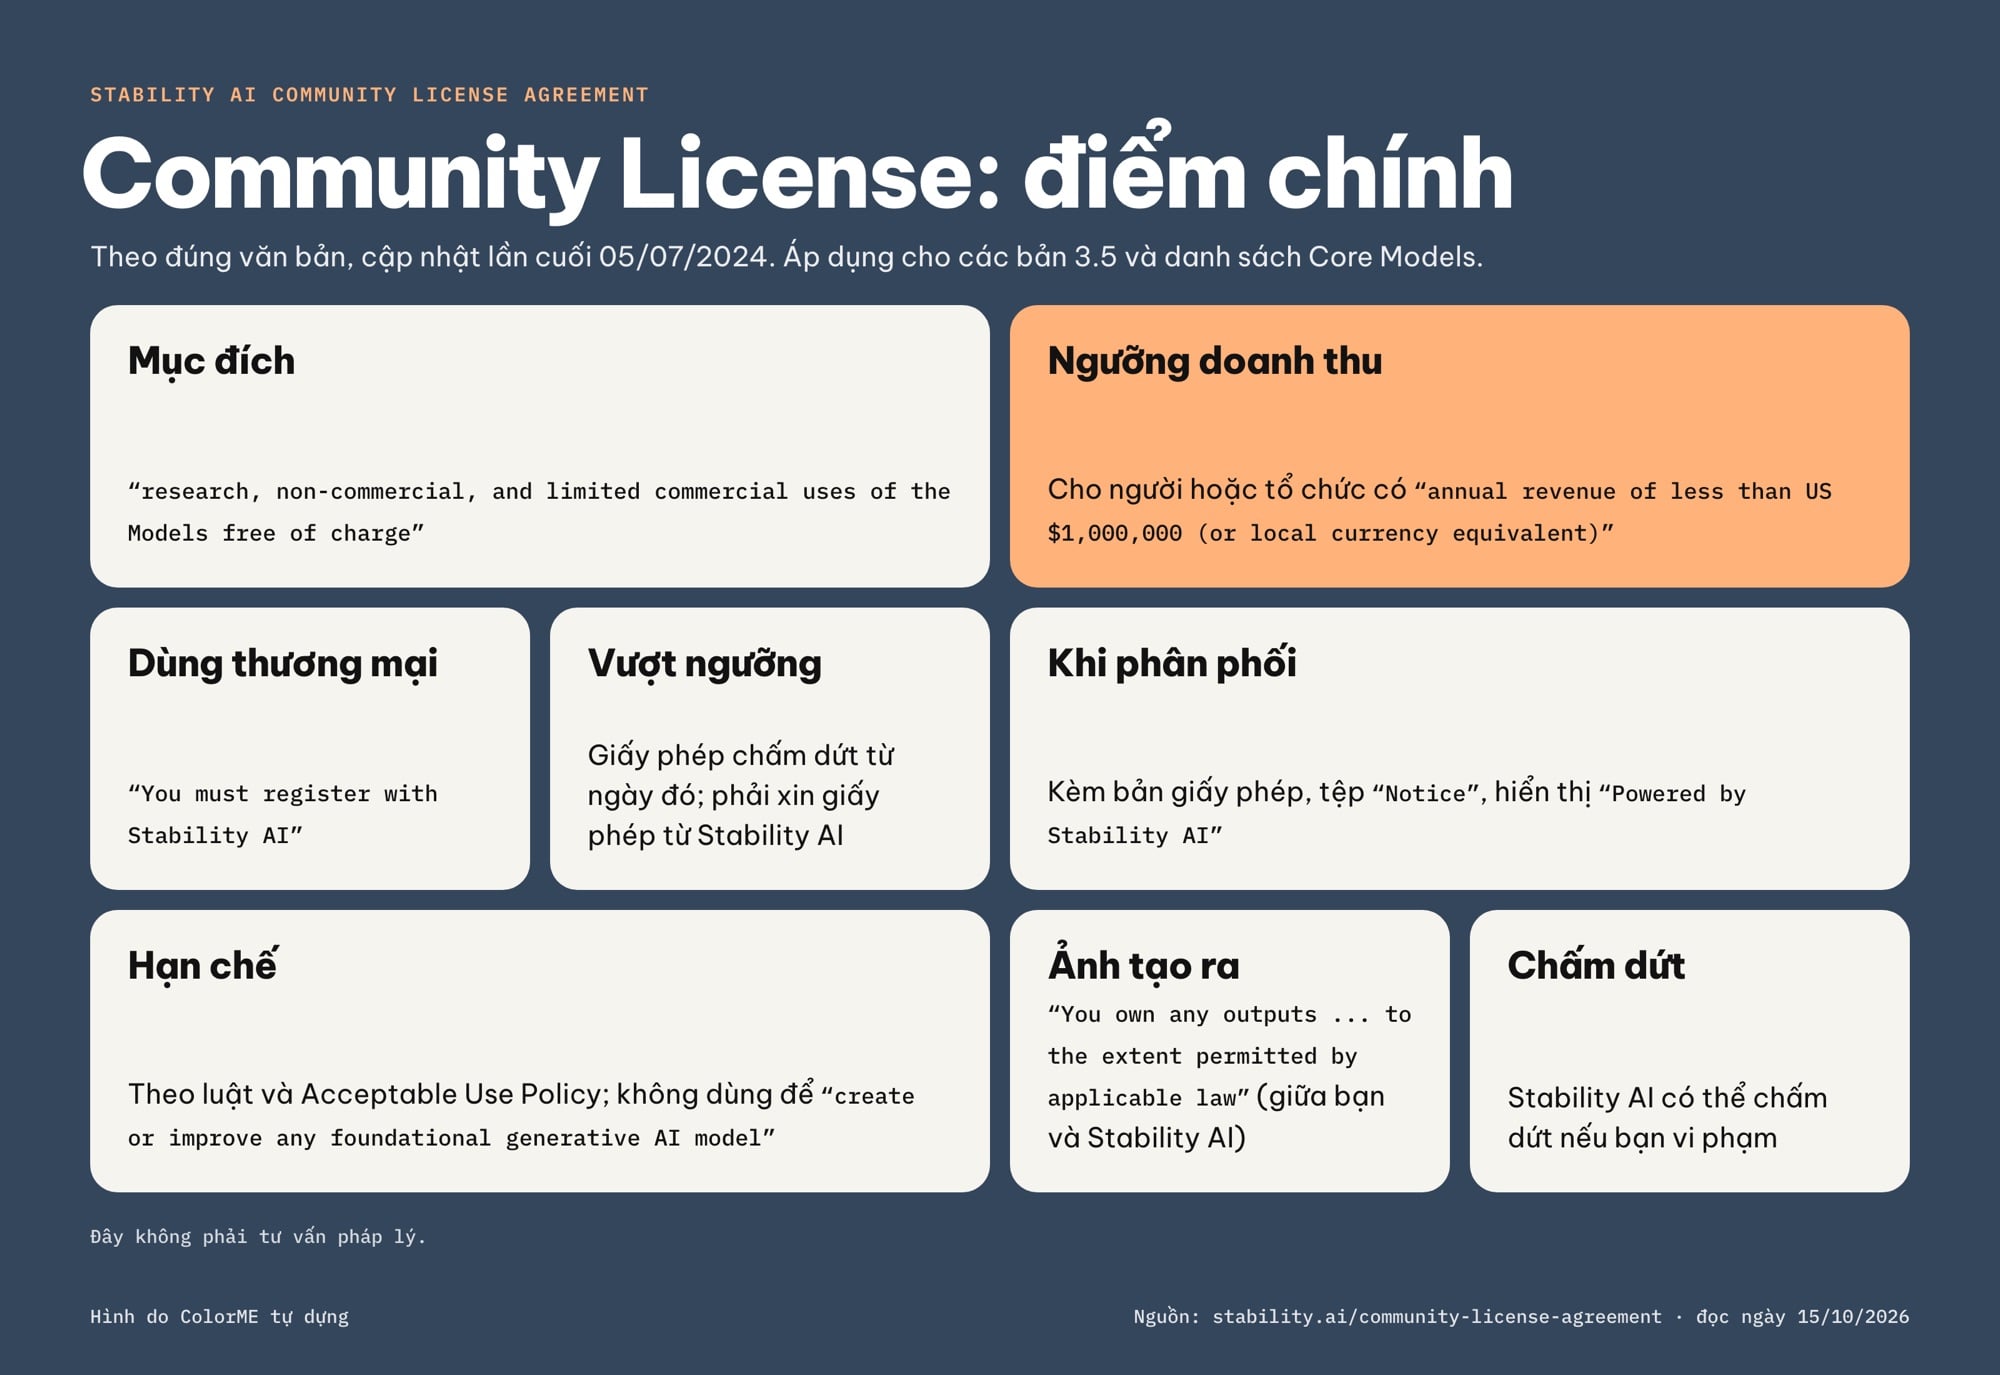
Điểm chính của Stability AI Community License, theo đúng văn bản. Hình do ColorME tự dựng.
Trang hỏi đáp giấy phép trả lời người sáng tạo cá nhân dùng ở nhà: "No you won't need to pay"; LoRA và fine-tune không bị coi là "foundational models" nên vẫn được làm (stability.ai/license). Hai điều cần để ý:
- Giấy phép theo từng mô hình. Community License áp dụng cho danh sách Core Models (trang cập nhật 20/05/2026): SD 3.5 Large, Large Turbo, Medium, SD 3 Medium, SDXL Turbo và một số mô hình khác. Các mô hình ngoài danh sách theo "each individual model's applicable license"; SDXL base 1.0 và v1 dùng giấy phép OpenRAIL như bảng đầu bài; bản tinh chỉnh của cộng đồng có thêm điều kiện của người làm. Mở thẻ mô hình, đọc mục License trước khi dùng.
- Doanh thu tính cả công ty. Giấy phép tính doanh thu của bạn "or Your Affiliate(s)", "regardless of whether that revenue is generated directly or indirectly" từ mô hình.
Bản quyền ảnh tạo bằng Stable Diffusion: những gì cần biết
1. Giữa bạn và Stability AI, ai sở hữu ảnh? Bạn, "to the extent permitted by applicable law". Cụm "trong phạm vi luật cho phép" nghĩa là giấy phép không hứa ảnh được luật bảo hộ quyền tác giả; nó chỉ nói Stability AI không đòi quyền với ảnh.
2. Luật Việt Nam nói gì về tác giả? Luật Sở hữu trí tuệ, sửa đổi bởi Luật số 07/2022/QH15, bổ sung Điều 12a: "Tác giả là người trực tiếp sáng tạo tác phẩm", và "Người hỗ trợ, góp ý kiến hoặc cung cấp tư liệu cho người khác sáng tạo tác phẩm không phải là tác giả, đồng tác giả" (Công báo: Luật số 07/2022/QH15, đăng trên trang Cục Bản quyền tác giả). Văn bản này không nhắc đến trí tuệ nhân tạo. Ảnh AI có được coi là tác phẩm không, ai là tác giả trong từng trường hợp, là việc của cơ quan có thẩm quyền và toà án; bài này không kết luận thay. Luật còn được sửa đổi năm 2025 (Luật số 131/2025/QH15) và Việt Nam đã có Luật Trí tuệ nhân tạo; mình chưa đọc văn bản chính thức hai luật này nên không trích. ColorME có tin về Luật Trí tuệ nhân tạo và vụ kiện bản quyền tác phẩm AI ở Mỹ. Luật đang thay đổi: dự án lớn thì hỏi luật sư.
3. Ảnh tạo ra có thể giống tác phẩm của người khác không? Có thể. Thẻ v1-4 viết dữ liệu không được lọc trùng và "we observe some degree of memorization for images that are duplicated in the training data". Giấy phép ghi ảnh tạo ra được cung cấp "AS IS", không bảo đảm "NON-INFRINGEMENT", và bạn "SOLELY RESPONSIBLE" khi dùng. Trách nhiệm kiểm tra nằm ở người dùng.
Cách làm thường gặp ở các studio cẩn thận: dùng ảnh AI làm phác thảo, moodboard, tham khảo bố cục; sản phẩm giao khách thì vẽ lại, chụp lại hoặc chỉnh đáng kể bằng tay; lưu prompt và tệp gốc; nói rõ với khách phần nào dùng AI.
Dùng Stable Diffusion có trách nhiệm
Ai dùng, phân phối hay tự chạy công nghệ của Stability AI đều phải theo Acceptable Use Policy (hiệu lực từ 30/09/2026), kể cả qua nền tảng bên thứ ba. Chính sách cấm, trong nhiều điều: vi phạm quyền sở hữu trí tuệ và quyền riêng tư, ảnh thân mật không có sự đồng thuận, "impersonation of others without consent or legal right", tin sai lệch, và làm người xem hiểu sai "(such as pretending it was made by a human)". Danh sách tự kiểm của mình:
- Không tạo ảnh người thật khi chưa được đồng ý, kể cả người nổi tiếng hay bạn bè.
- Không ghi tên hoạ sĩ, nhiếp ảnh gia đang sống vào prompt để bắt chước phong cách. Đây là quy tắc của ColorME: tôn trọng người làm nghề.
- Không đưa logo, nhân vật, thương hiệu của người khác vào ảnh dùng thương mại.
- Nói rõ ảnh có dùng AI khi đăng hoặc giao khách.
- Kiểm tra ảnh trước khi dùng: chữ, bàn tay, khuôn mặt, và độ giống ảnh có sẵn.
- Đọc giấy phép của đúng mô hình, ghi "Powered by Stability AI" nếu phân phối sản phẩm dùng mô hình 3.5.
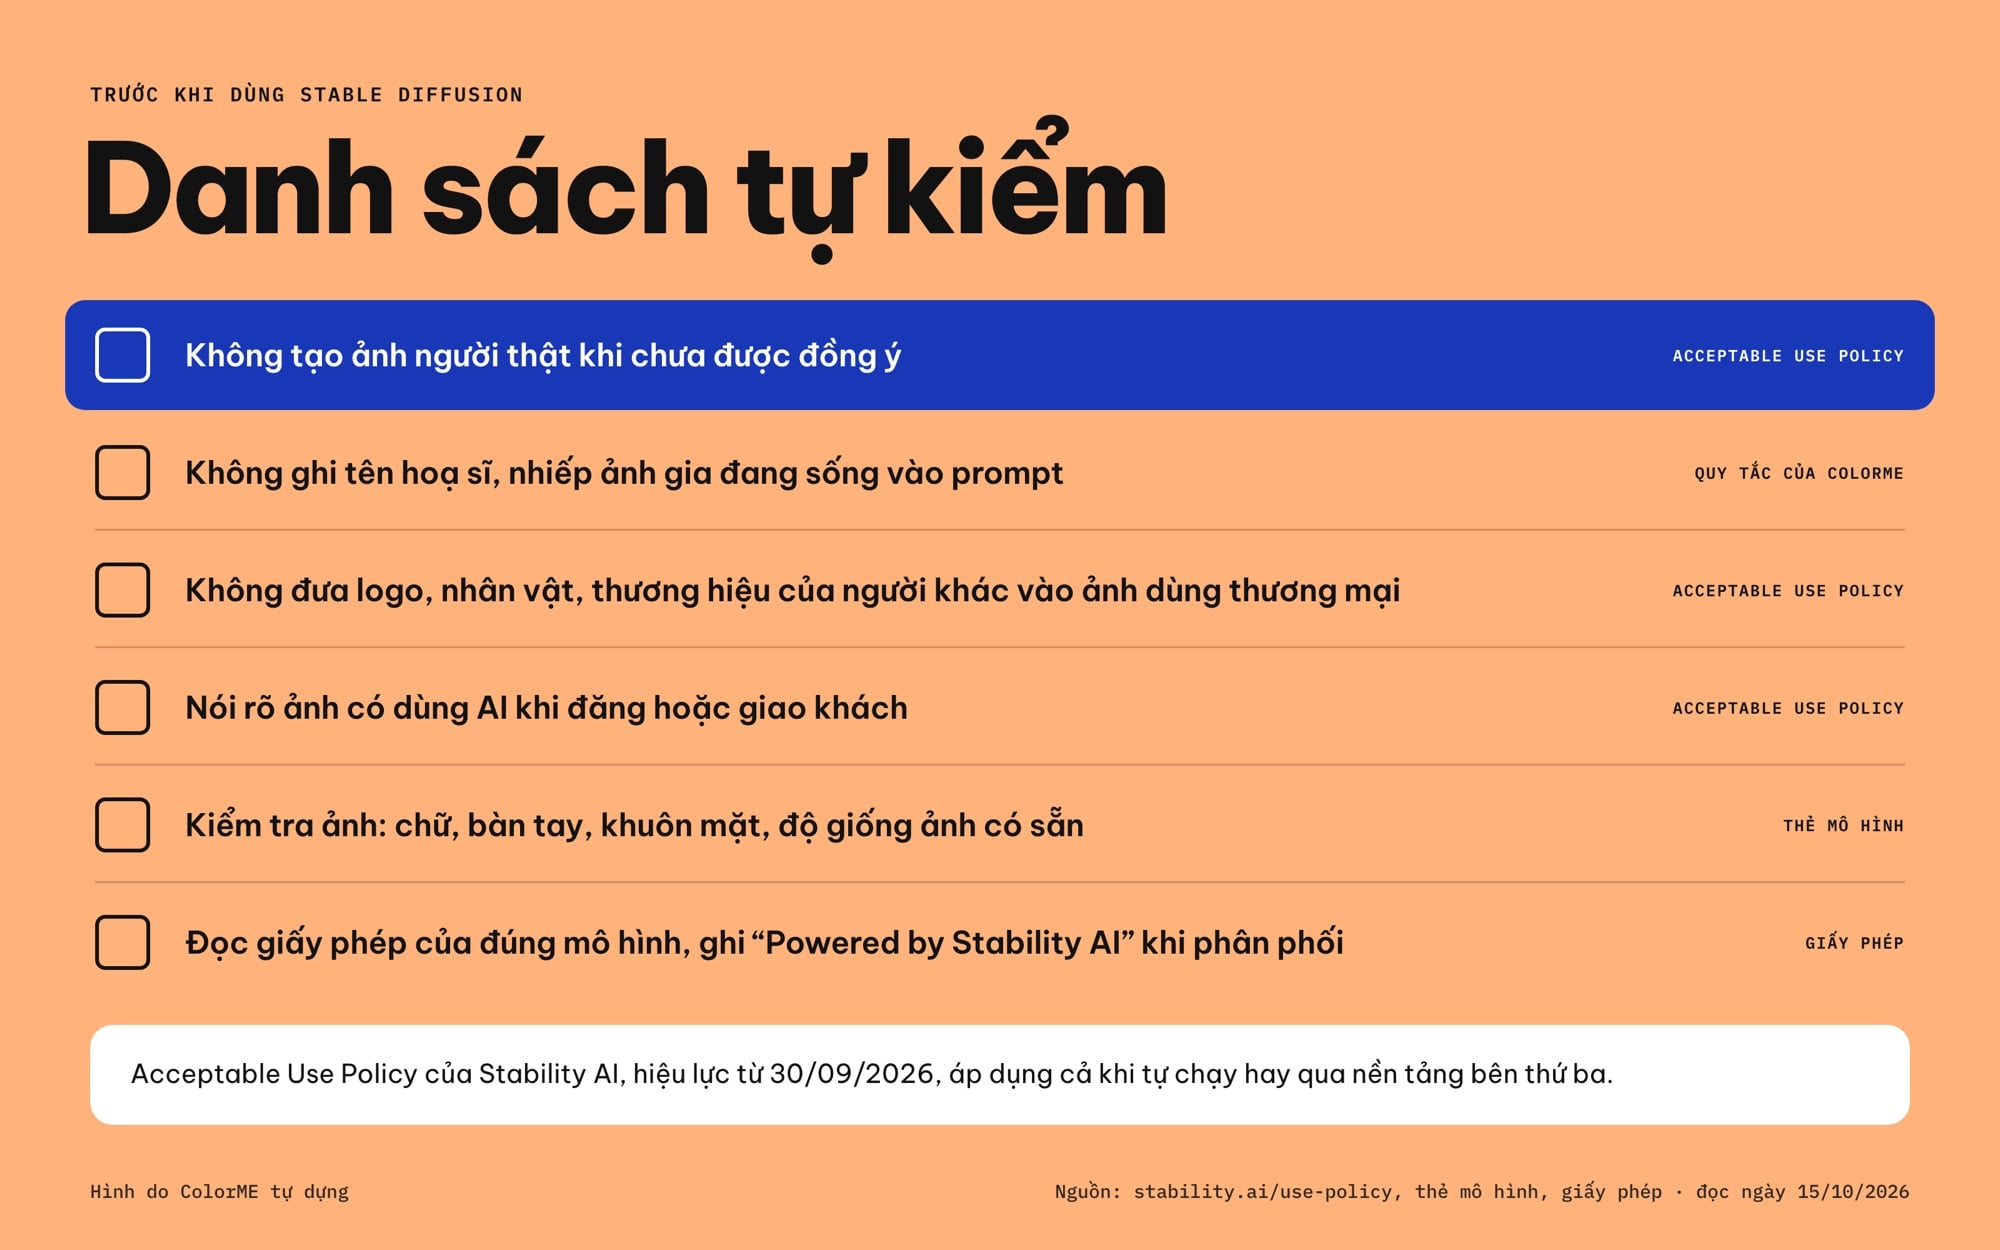
Sáu điều tự kiểm khi dùng Stable Diffusion. Hình do ColorME tự dựng.
Công cụ ColorME liên quan
Viết prompt là phần khó với người mới. Trang Cải thiện prompt AI ghi: "Bạn chọn Midjourney, GPT Image / Nano Banana, Stable Diffusion / Flux hoặc video AI. Mỗi lựa chọn được viết theo cú pháp và tham số phù hợp với công cụ đó." Với Stable Diffusion / Flux, "AI viết thêm negative prompt để loại bỏ lỗi thường gặp". Trang cũng ghi: "Công cụ AI này hiện dành cho tài khoản được ColorME cấp quyền dùng AI, bạn cần đăng nhập để chạy." Mình chưa thử công cụ này cho bài.
Muốn tạo ảnh từ mô tả tiếng Việt mà không cài gì, trang Tạo ảnh bằng AI ghi: "Công cụ AI hiện dành cho tài khoản được ColorME cấp quyền và cần đăng nhập." Trang không nói dùng mô hình nào, nên đừng hiểu đó là Stable Diffusion. So sánh các công cụ khác, xem bài tạo ảnh bằng AI với Gemini, ChatGPT, Copilot, Canva. Dùng AI của Google thì xem Gemini tạo ảnh và Nano Banana là gì.
Câu hỏi thường gặp về Stable Diffusion
Stable Diffusion có miễn phí không?
Với các bản 3.5, trang giấy phép viết người dùng cá nhân ở nhà "won't need to pay", và dùng thương mại không trả phí khi doanh thu năm dưới 1 triệu USD (phải đăng ký). Chạy trên máy thì bạn tự lo phần cứng; dùng đám mây thì theo điều khoản dịch vụ đó.
Cần card đồ hoạ bao nhiêu GB?
Tuỳ mô hình và phần mềm; xem bảng ở mục Cách chạy. Không nguồn chính thức nào đưa một con số chung cho mọi bản Stable Diffusion.
Ảnh tạo bằng Stable Diffusion có bản quyền không?
Giấy phép nói bạn sở hữu ảnh "to the extent permitted by applicable law". Luật Việt Nam định nghĩa tác giả là "người trực tiếp sáng tạo tác phẩm"; áp dụng cho ảnh AI thế nào do cơ quan có thẩm quyền quyết định. Đây không phải tư vấn pháp lý.