Tutorial · 21/10/2026
Cách tách giọng khỏi nhạc: Audition, AI và giới hạn cần biết
 COLOR ME21/10/2026 · 10 phút đọc · 3 lượt xem
Cách tách giọng khỏi nhạc: trừ kênh bằng Center Channel Extractor trong Audition, tách bằng AI với Demucs, UVR; bài thử của ColorME cho thấy mỗi cách sạch tới đâu.
Muốn tách giọng khỏi nhạc, có hai hướng: trừ kênh (giữ phần khác nhau giữa kênh trái và phải, bỏ phần nằm giữa) bằng hiệu ứng Center Channel Extractor trong Adobe Audition, hoặc dùng mô hình AI tách nguồn như Demucs, Ultimate Vocal Remover để lấy riêng giọng, trống, bass. Trừ kênh nhanh, nhẹ nhưng chỉ sạch khi giọng hát được đặt đúng giữa và không có vang stereo; AI tách sạch hơn nhưng nặng hơn. ColorME đã dựng một bài thử nhỏ (giọng đọc tổng hợp tiếng Việt và vài nốt đàn, không dùng bài hát có bản quyền) để bạn thấy tận mắt mỗi cách làm được tới đâu.
| Bạn cần | Nên dùng |
|---|---|
| Bản karaoke nhanh để tập hát | Trừ kênh: Center Channel Extractor (Audition) hoặc lệnh ffmpeg |
| Lấy riêng giọng hát (acapella) hoặc beat để tập remix | Mô hình AI: Demucs, Ultimate Vocal Remover |
| Giữ bass, trống khi bỏ giọng | Mô hình AI (trừ kênh làm mất cả bass, kick ở giữa) |
| Lọc giọng nói khỏi nhạc nền, tiếng ồn trong vlog, phỏng vấn | Công cụ lọc giọng nói, không phải công cụ tách bài hát |
Tách giọng khỏi nhạc hoạt động thế nào?
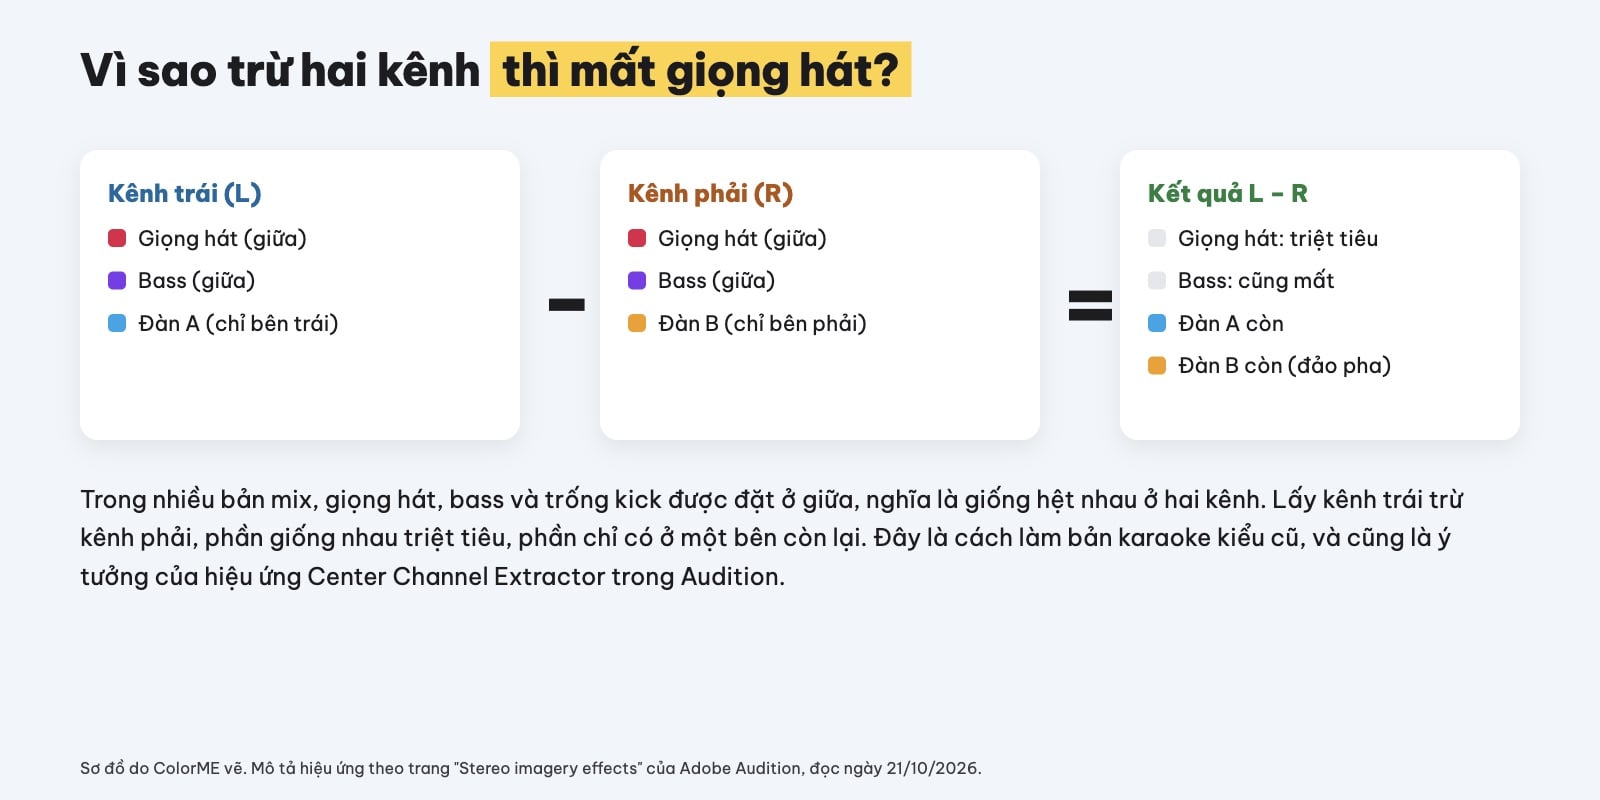
Nguyên lý trừ kênh: phần nằm giữa hai kênh triệt tiêu. Sơ đồ do ColorME vẽ.
Một bài hát stereo có hai kênh, trái và phải. Khi phối nhạc, người ta thường đặt giọng hát chính ở giữa, nghĩa là giọng xuất hiện giống hệt nhau ở cả hai kênh. Trang trợ giúp của Adobe Audition về hiệu ứng Center Channel Extractor ghi rõ điều này: giọng hát, bass và nhạc cụ chính thường được thu và đặt ở giữa, vì vậy có thể dùng hiệu ứng để làm to giọng, bass, kick, hoặc bỏ chúng đi để tạo bản karaoke.
Ý tưởng đơn giản nhất là lấy kênh trái trừ kênh phải. Phần giống nhau ở hai kênh (giọng hát nằm giữa) triệt tiêu, phần chỉ có ở một bên (cây đàn đặt lệch trái, lệch phải) còn lại. Đây là cách các máy karaoke đời cũ dùng để "bỏ lời". Center Channel Extractor của Audition làm tinh hơn: nó phân tích từng dải tần theo pha và biên độ, cho chọn dải tần cần xử lý, chứ không trừ thẳng cả hai kênh.
Hướng thứ hai là mô hình AI tách nguồn (source separation). Mô hình đã được huấn luyện trên rất nhiều bài nhạc có sẵn các phần tách rời, nên nó "nghe" và tách giọng, trống, bass, phần còn lại thành từng file riêng, không phụ thuộc giọng có nằm giữa hay không.
ColorME thử: trừ kênh làm được tới đâu?
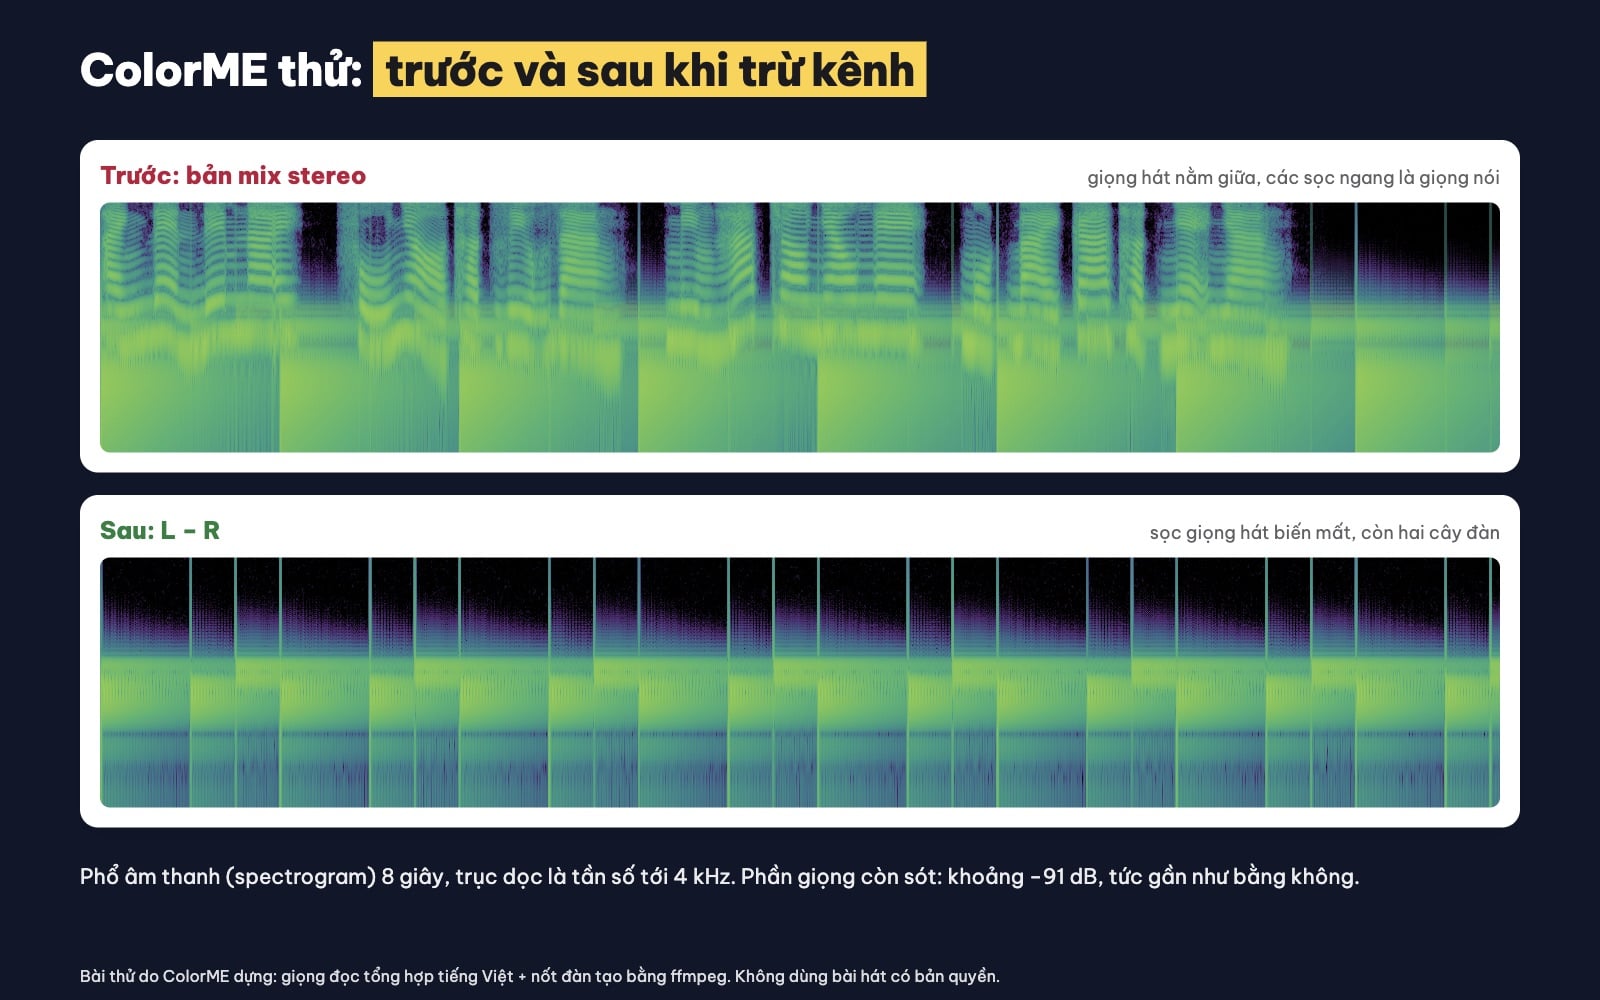
Bài thử của ColorME: phổ âm thanh trước và sau khi trừ kênh.
Để kiểm tra, ColorME dựng một bản mix stereo dài 8 giây: giọng đọc tiếng Việt tổng hợp bằng giọng Linh của macOS đặt ở giữa, một tiếng bass cũng đặt ở giữa, một hợp âm đàn chỉ có ở kênh trái và một hợp âm khác chỉ có ở kênh phải. Tất cả do mình tạo, nên không có vấn đề bản quyền. Sau đó lấy kênh trái trừ kênh phải bằng ffmpeg:
ffmpeg -i mix.wav -af "pan=stereo|c0=c0-c1|c1=c1-c0" karaoke.wavKết quả trong hình: ở phổ âm thanh (spectrogram) của bản mix, giọng nói hiện ra thành các sọc ngang lượn sóng ở dải tần cao. Sau khi trừ kênh, toàn bộ sọc đó biến mất, chỉ còn các nốt đàn. Đo bằng bộ lọc volumedetect của ffmpeg, phần giọng còn sót lại ở mức trung bình khoảng −91 dB, tức gần như bằng không. Nhưng tiếng bass ở giữa cũng mất theo, đúng như lý thuyết.
Giới hạn: vì sao bài hát thật khó tách sạch?
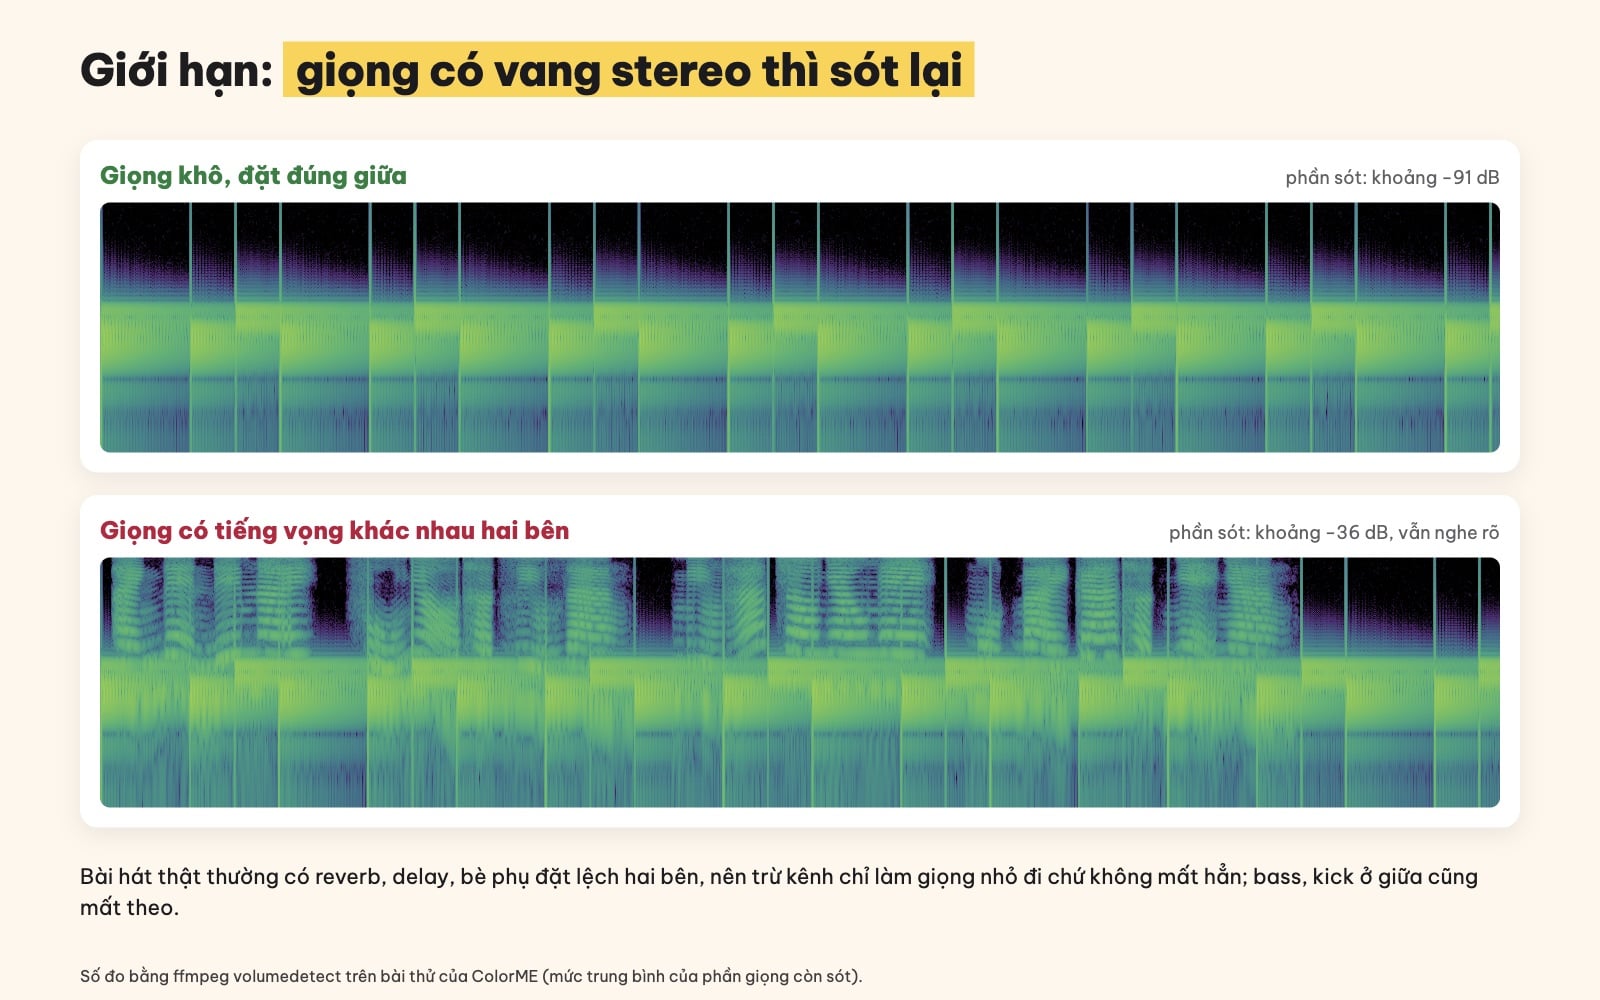
Giọng có tiếng vọng stereo vẫn sót lại sau khi trừ kênh.
Bài thử trên là trường hợp lý tưởng: giọng khô, đặt đúng giữa. Bài hát thật hiếm khi như vậy. Giọng thường có reverb (tiếng vang) và delay (tiếng vọng) trải rộng hai bên, có bè phụ đặt lệch, có hiệu ứng stereo. Những phần đó khác nhau giữa hai kênh nên không triệt tiêu.
ColorME thử lại với cùng giọng đọc, nhưng thêm tiếng vọng khác nhau ở mỗi kênh (60 ms bên trái, 95 ms bên phải). Lần này, sau khi trừ kênh, phần giọng còn sót ở mức trung bình khoảng −36 dB, so với giọng gốc trong bản mix khoảng −25 dB. Giọng nhỏ đi rõ, nhưng vẫn nghe được như một tiếng vang mờ. Đó là lý do bản karaoke làm bằng trừ kênh thường còn "hồn ma" của giọng hát.
Ba dấu hiệu cho thấy bài hát khó tách bằng trừ kênh:
- Nghe bằng tai nghe thấy giọng "rộng", vang khắp hai bên thay vì nằm gọn ở giữa.
- Bài có bè, hoà âm nhiều giọng.
- Bài thu âm mono hoặc bản cũ gần như mono: hai kênh gần giống nhau, trừ kênh sẽ làm mất gần hết cả bài.
Cách kiểm tra nhanh trước khi mất công: trừ kênh một đoạn 10 đến 20 giây của bài (bằng Audition hoặc lệnh ffmpeg ở trên) rồi nghe bằng tai nghe. Nếu giọng gần như biến mất, cứ tiếp tục bằng trừ kênh. Nếu giọng chỉ nhỏ đi một chút, hoặc cả bài trở nên rất nhỏ và rỗng, chuyển sang mô hình AI để đỡ mất thời gian chỉnh thông số.
Cách tách giọng trong Adobe Audition (Center Channel Extractor)
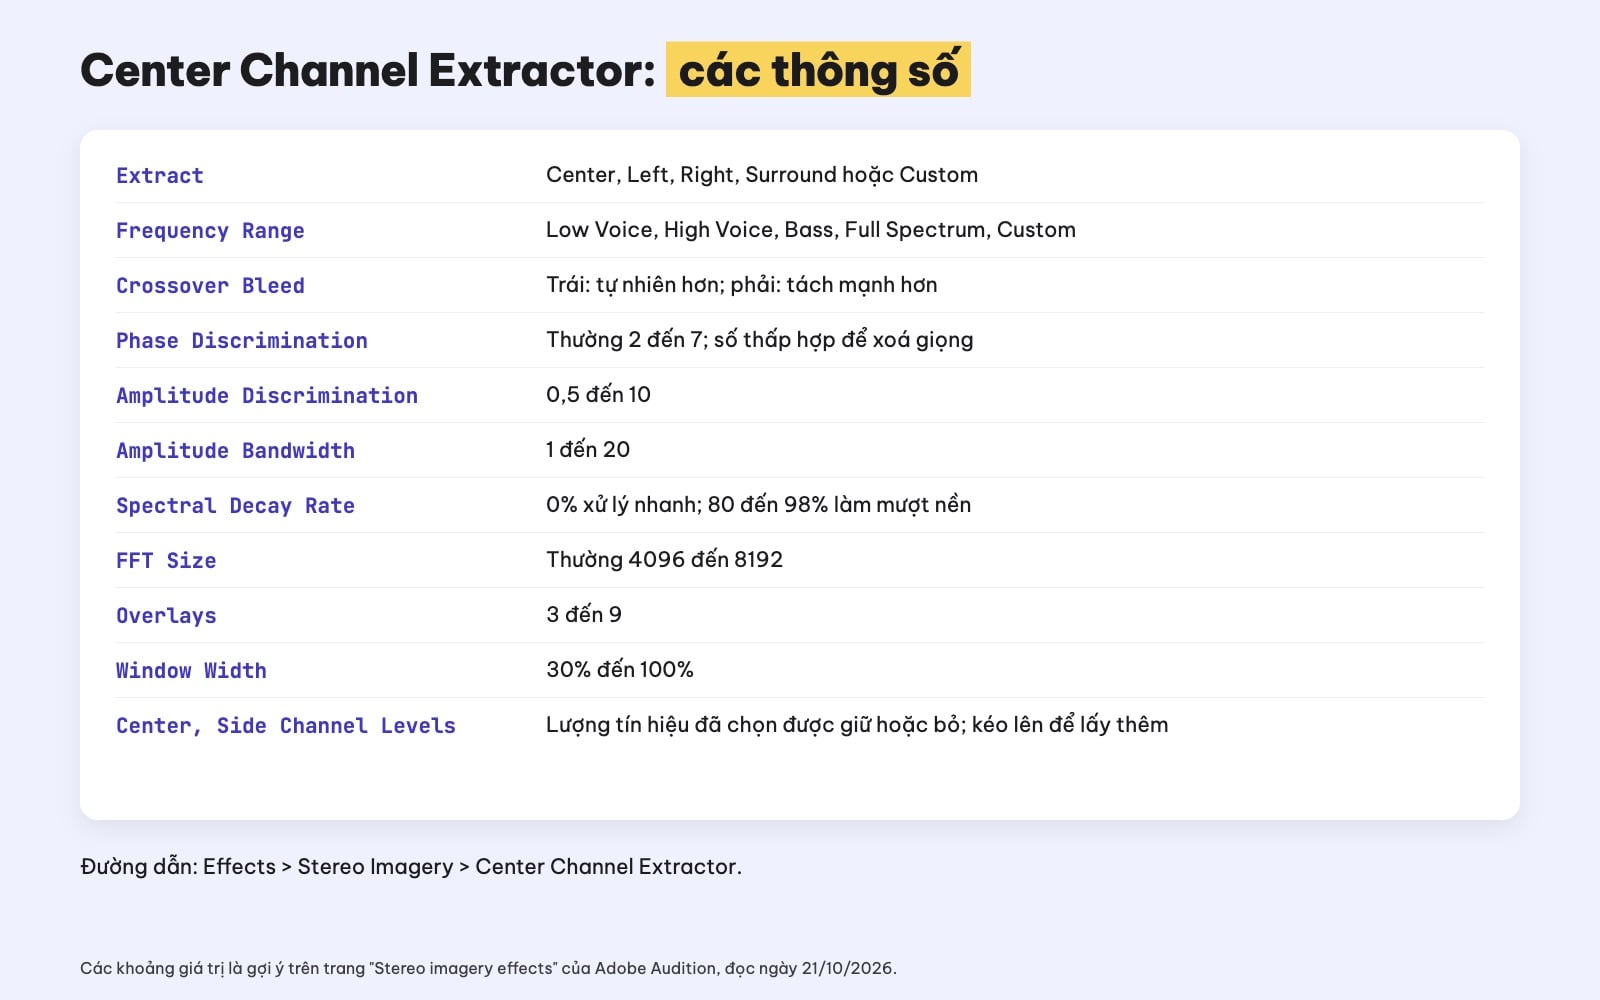
Các thông số của Center Channel Extractor, theo trang trợ giúp Adobe Audition.
Nếu bạn đã có Audition, đây là cách nhanh nhất để thử. Phần giới thiệu phần mềm có trong bài Adobe Audition là gì. Các bước:
- Mở file nhạc stereo trong Audition (Waveform Editor).
- Chọn Effects > Stereo Imagery > Center Channel Extractor.
- Ở mục Extract, chọn Center (phần nằm giữa, thường là giọng hát).
- Ở Frequency Range, chọn dải gần với giọng: Low Voice, High Voice, hoặc Full Spectrum; chọn Custom nếu muốn tự đặt dải tần.
- Chỉnh mức Center và Side Channel Levels để quyết định giữ hay bỏ bao nhiêu phần tín hiệu đã chọn, nghe thử rồi áp dụng.
Theo trang "Stereo imagery effects" của Adobe Audition (đọc ngày 21/10/2026), ý nghĩa và khoảng gợi ý của các thông số chính:
- Crossover Bleed: kéo sang trái để tiếng lọt qua nhiều hơn, nghe tự nhiên hơn; kéo sang phải để tách phần giữa khỏi bản mix mạnh hơn.
- Phase Discrimination: số cao thường tốt hơn khi muốn lấy riêng phần giữa, số thấp tốt hơn khi muốn bỏ phần giữa. Adobe ghi khoảng 2 đến 7 thường cho kết quả tốt.
- Amplitude Discrimination và Amplitude Bandwidth: số thấp cắt nhiều hơn khỏi bản mix nhưng có thể cắt luôn cả giọng; khoảng gợi ý lần lượt 0,5 đến 10 và 1 đến 20.
- Spectral Decay Rate: để 0% cho xử lý nhanh; đặt 80% đến 98% để làm mượt các méo tiếng ở nền.
- FFT Size: thấp thì xử lý nhanh, cao thì chất lượng tốt hơn; thường 4096 đến 8192.
- Overlays: 3 đến 9; số cao cho tiếng mượt hơn nhưng lâu hơn, số thấp có thể sinh tiếng lục bục ở nền.
- Window Width: 30% đến 100%.
Mẹo: Center Channel Extractor cũng làm được việc ngược lại, tức là giữ phần giữa để lấy giọng hát gần như riêng. Kết quả thường còn lẫn bass, kick vì chúng cũng nằm giữa; chọn Frequency Range kiểu Voice để giới hạn dải tần giúp đỡ lẫn hơn.
Tách giọng bằng AI: Demucs và Ultimate Vocal Remover
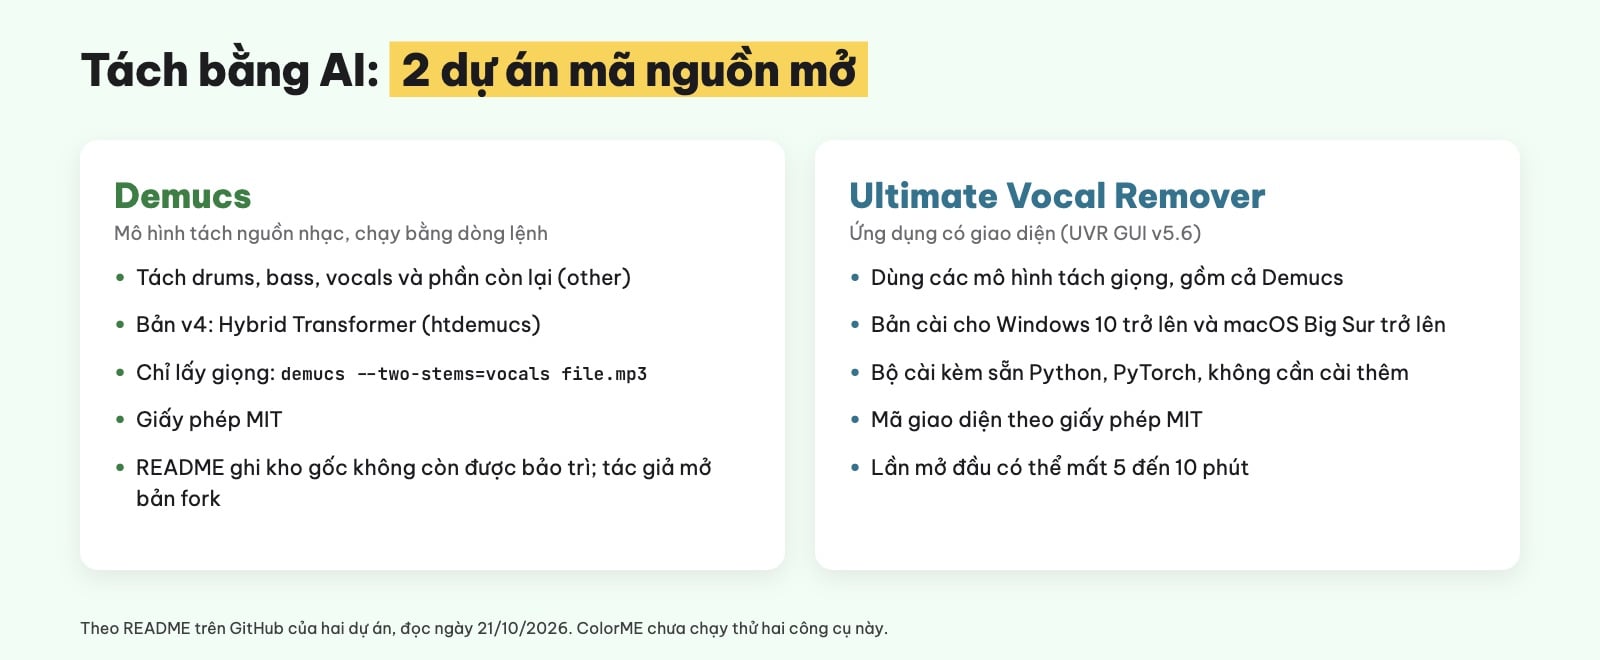
Demucs và Ultimate Vocal Remover, theo README trên GitHub.
Khi bài hát có nhiều vang, bè, hay bạn cần giữ nguyên bass và trống, mô hình AI là lựa chọn tốt hơn. Hai dự án mã nguồn mở hay được nhắc tới nhất, theo README trên GitHub của chính dự án (đọc ngày 21/10/2026):
Demucs
- Mô hình tách nguồn nhạc, tách được trống (drums), bass, giọng hát (vocals) và phần còn lại (other).
- Bản v4 dùng Hybrid Transformer Demucs (htdemucs). Có thêm một mô hình thử nghiệm 6 nguồn, tách thêm guitar và piano; README ghi guitar tạm ổn nhưng piano còn lẫn nhiều.
- Muốn chỉ tách giọng ra khỏi phần còn lại, dùng tuỳ chọn
--two-stems=vocals, ví dụdemucs --two-stems=vocals myfile.mp3. - Phát hành theo giấy phép MIT. README cũng ghi kho gốc không còn được bảo trì; tác giả đã mở một bản fork và chỉ sửa các lỗi quan trọng.
Ultimate Vocal Remover (UVR)
- Ứng dụng có giao diện (README ghi bản UVR GUI v5.6), dùng các mô hình tách nguồn để bỏ giọng khỏi file âm thanh; ngoài các mô hình do nhóm phát triển tự huấn luyện, có cả các mô hình Demucs v3, v4.
- Có bộ cài cho Windows 10 trở lên và macOS Big Sur trở lên; bộ cài kèm sẵn Python, PyTorch và các thành phần cần thiết.
- Lần mở đầu tiên có thể mất 5 đến 10 phút, tuỳ máy.
- Mã giao diện theo giấy phép MIT.
ColorME chưa chạy thử hai công cụ này trên máy của mình, nên bài không đưa ra so sánh chất lượng. Nếu dùng, hãy tải từ trang GitHub chính thức của dự án.
Chọn cách nào cho việc của bạn?
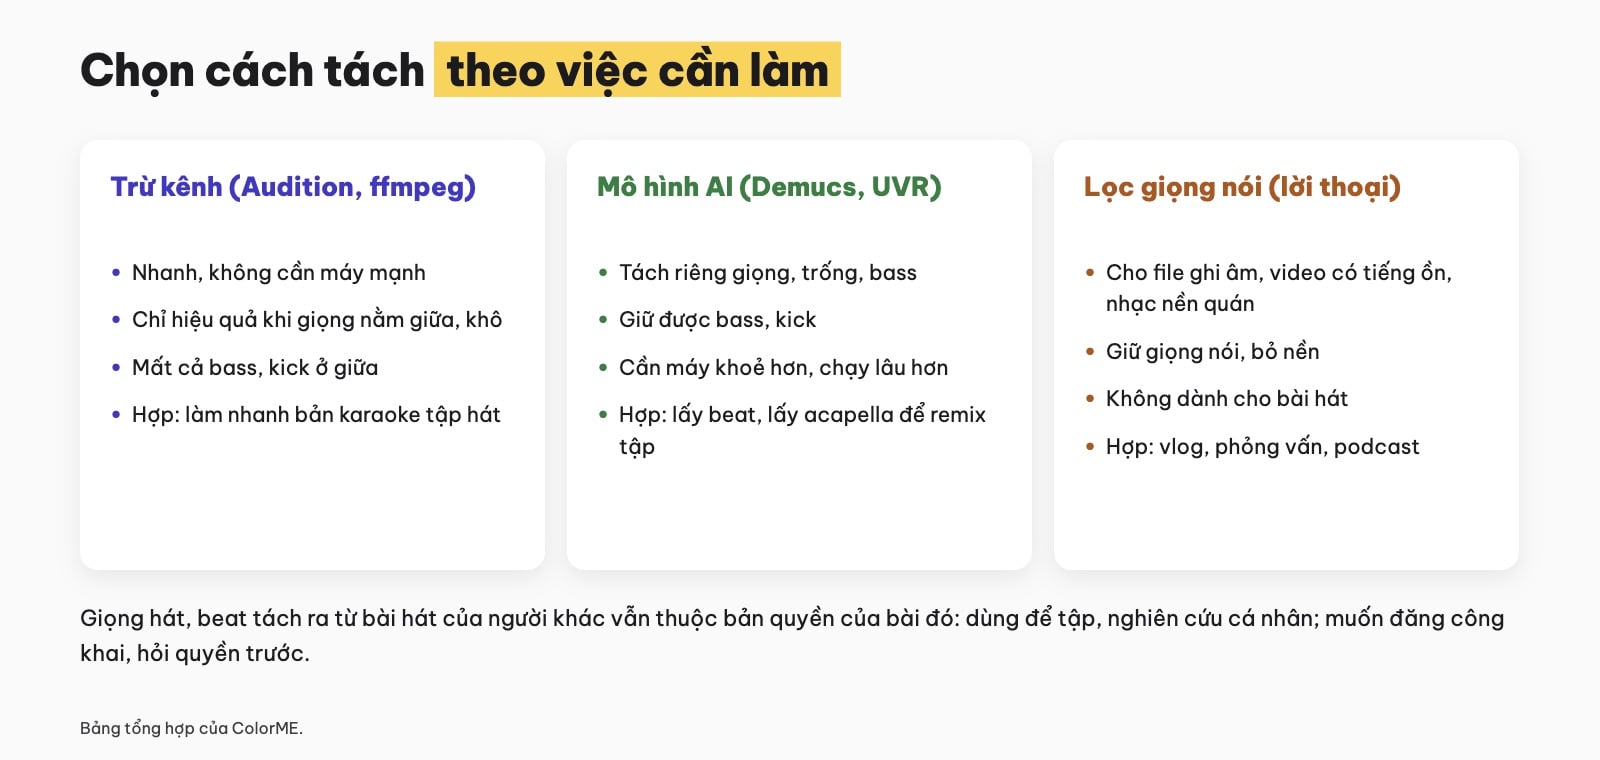
Chọn cách tách theo việc cần làm.
- Tập hát, cần bản karaoke nhanh: trừ kênh là đủ, nhất là với bài phối đơn giản. Chấp nhận mất bass và còn chút vang.
- Remix, làm video có beat riêng để tập: dùng mô hình AI để giữ bass, trống.
- Vlog, phỏng vấn, podcast bị lẫn nhạc nền quán hay tiếng ồn: đây là bài toán lọc giọng nói, khác với tách bài hát. Có thể thử công cụ lọc tạp âm, tách giọng nói của ColorME hoặc đọc bài Adobe Podcast Enhance Speech.
- Chỉ cần lấy âm thanh từ video trước khi tách: dùng công cụ tách nhạc từ video sang MP3, rồi cắt đoạn cần dùng bằng công cụ cắt nhạc.
Lưu ý về bản quyền
Giọng hát hay beat tách ra từ bài hát của người khác vẫn thuộc bản quyền của bài hát đó. Tách để tập hát, tập phối, nghiên cứu cho riêng mình là một chuyện; đăng bản karaoke, bản remix lên mạng hay dùng làm nhạc nền video thương mại là chuyện khác, cần xin phép chủ sở hữu hoặc dùng nhạc có giấy phép phù hợp. Khi làm video, cách an toàn nhất là dùng nhạc bạn có quyền sử dụng ngay từ đầu.
Mẹo để kết quả tốt hơn
- Dùng file gốc chất lượng cao: WAV hoặc MP3 bitrate cao thường tách sạch hơn file nén mạnh, vì nén có thể làm phần nằm giữa không còn giống hệt nhau ở hai kênh.
- Nghe bằng tai nghe: phần sót lại của giọng, tiếng méo thường khó nghe qua loa máy tính.
- Kết hợp hai cách: tách bằng AI trước, nếu còn sót thì lọc thêm theo dải tần; đừng xử lý quá mạnh vì nhạc sẽ "rỗng" và méo.
- Bù lại bass khi trừ kênh: nếu bản karaoke nghe mỏng, có thể giới hạn dải tần xử lý (Frequency Range) để không đụng tới dải bass.
- Lưu bản gốc: luôn làm trên bản sao, giữ file gốc để thử lại với thông số khác.
Muốn đi xa hơn với dựng video, xử lý âm thanh cho video và chỉnh màu, xem khoá Premiere của ColorME.
Câu hỏi thường gặp
Tách giọng khỏi nhạc bằng Audition thế nào?
Mở file stereo, chọn Effects > Stereo Imagery > Center Channel Extractor, chọn Extract là Center và một Frequency Range kiểu giọng, chỉnh mức Center và Side Channel Levels rồi áp dụng.
Vì sao bản karaoke vẫn còn tiếng hát mờ?
Vì phần vang, tiếng vọng, bè phụ của giọng khác nhau giữa hai kênh nên không triệt tiêu. Trong bài thử của ColorME, giọng có vọng stereo còn sót khoảng −36 dB thay vì gần như bằng không.
Tách giọng có làm mất bass không?
Với cách trừ kênh thì có, vì bass và kick thường cũng đặt ở giữa. Mô hình AI như Demucs tách bass thành một phần riêng nên giữ được.
Demucs tách được những phần nào?
Theo README, Demucs tách trống, bass, giọng hát và phần còn lại; có mô hình thử nghiệm tách thêm guitar và piano. Tuỳ chọn --two-stems=vocals chỉ tách giọng ra khỏi phần còn lại.
Có được đăng bản karaoke tách từ bài hát lên mạng không?
Bài hát gốc vẫn có bản quyền, nên muốn đăng công khai cần xin phép chủ sở hữu hoặc dùng nhạc có giấy phép. Tách để tập cho riêng mình thì khác.
Tác giảCOLOR ME